01
Random Code Programming
 arquivo
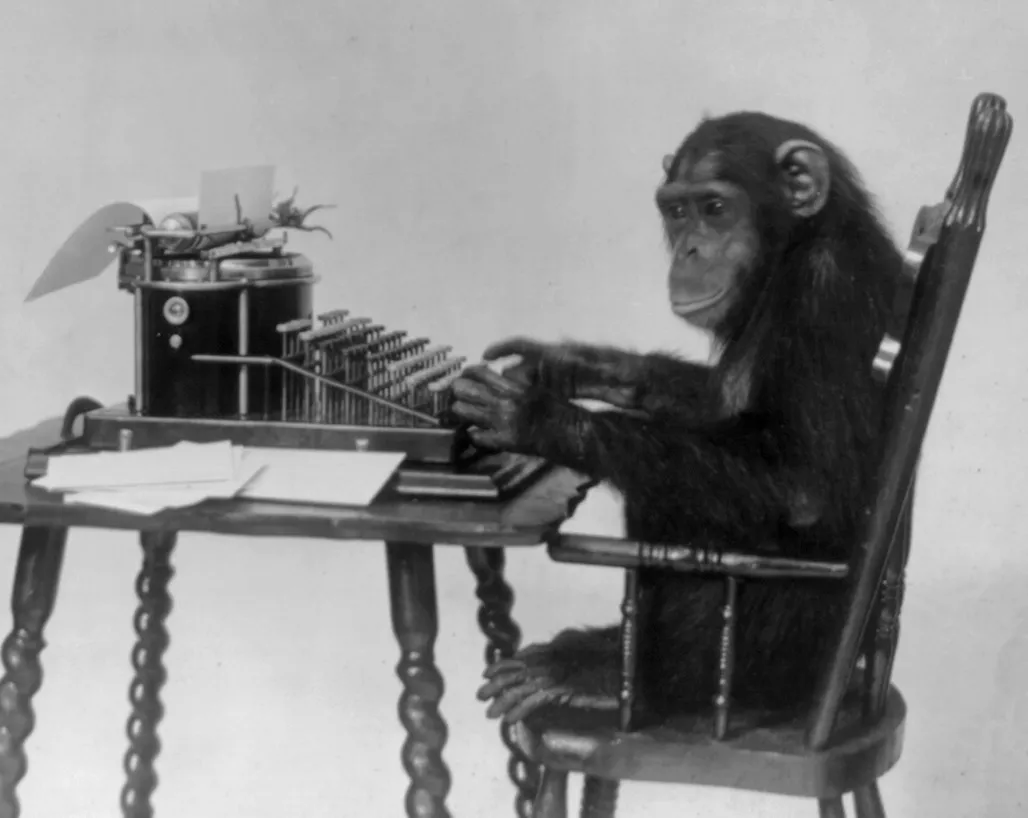
Em 2017 Victor Pelevin lançou o romance iPhuck 10, cujo protagonista, Porfiri Petróvitch, trabalha como robô policial e literário: ele desvenda crimes, de quebra escreve romances policiais sobre eles e trata as pessoas com aquela ternura condescendente de um adulto que ouve crianças tentando lhe explicar como funciona um televisor. Em algum ponto da segunda parte do romance descobrimos de onde vêm, afinal, criaturas assim, e a explicação soa como uma zombaria de toda a ciência da computação de uma só vez. Um certo Reznik, criador do método, conta que ninguém escreve o programa: as máquinas geram sequências aleatórias de código, cada uma delas passa depois por testes exaustivos, e fica o que por acaso funcionou. Para ilustrar, Pelevin lembra o macaco que, se receber uma máquina de escrever e tempo suficiente, mais cedo ou mais tarde vai datilografar Guerra e Paz. O método se chama Random Code Programming, programação por código aleatório, e o romance diz que ele não exige grande inteligência e se parece sobretudo com bordado.
Em 2017 isso se lia como mais uma piada de Pelevin, daquelas em que um mecanismo absurdo é apresentado no tom de documentação técnica para que o leitor primeiro ria e depois, por um segundo, se pergunte se aquilo é mesmo engraçado. Os programadores, aliás, não tinham por que se perguntar nada, porque qualquer um deles podia mostrar num guardanapo, em cinco minutos, que o macaco na máquina de escrever empacaria já na primeira função com sentido, de dez linhas, sem nunca chegar perto de Guerra e Paz.
Passaram-se só alguns anos, e descobriu-se que Pelevin tinha errado num detalhe, e que esse detalhe era decisivo.
 arquivo
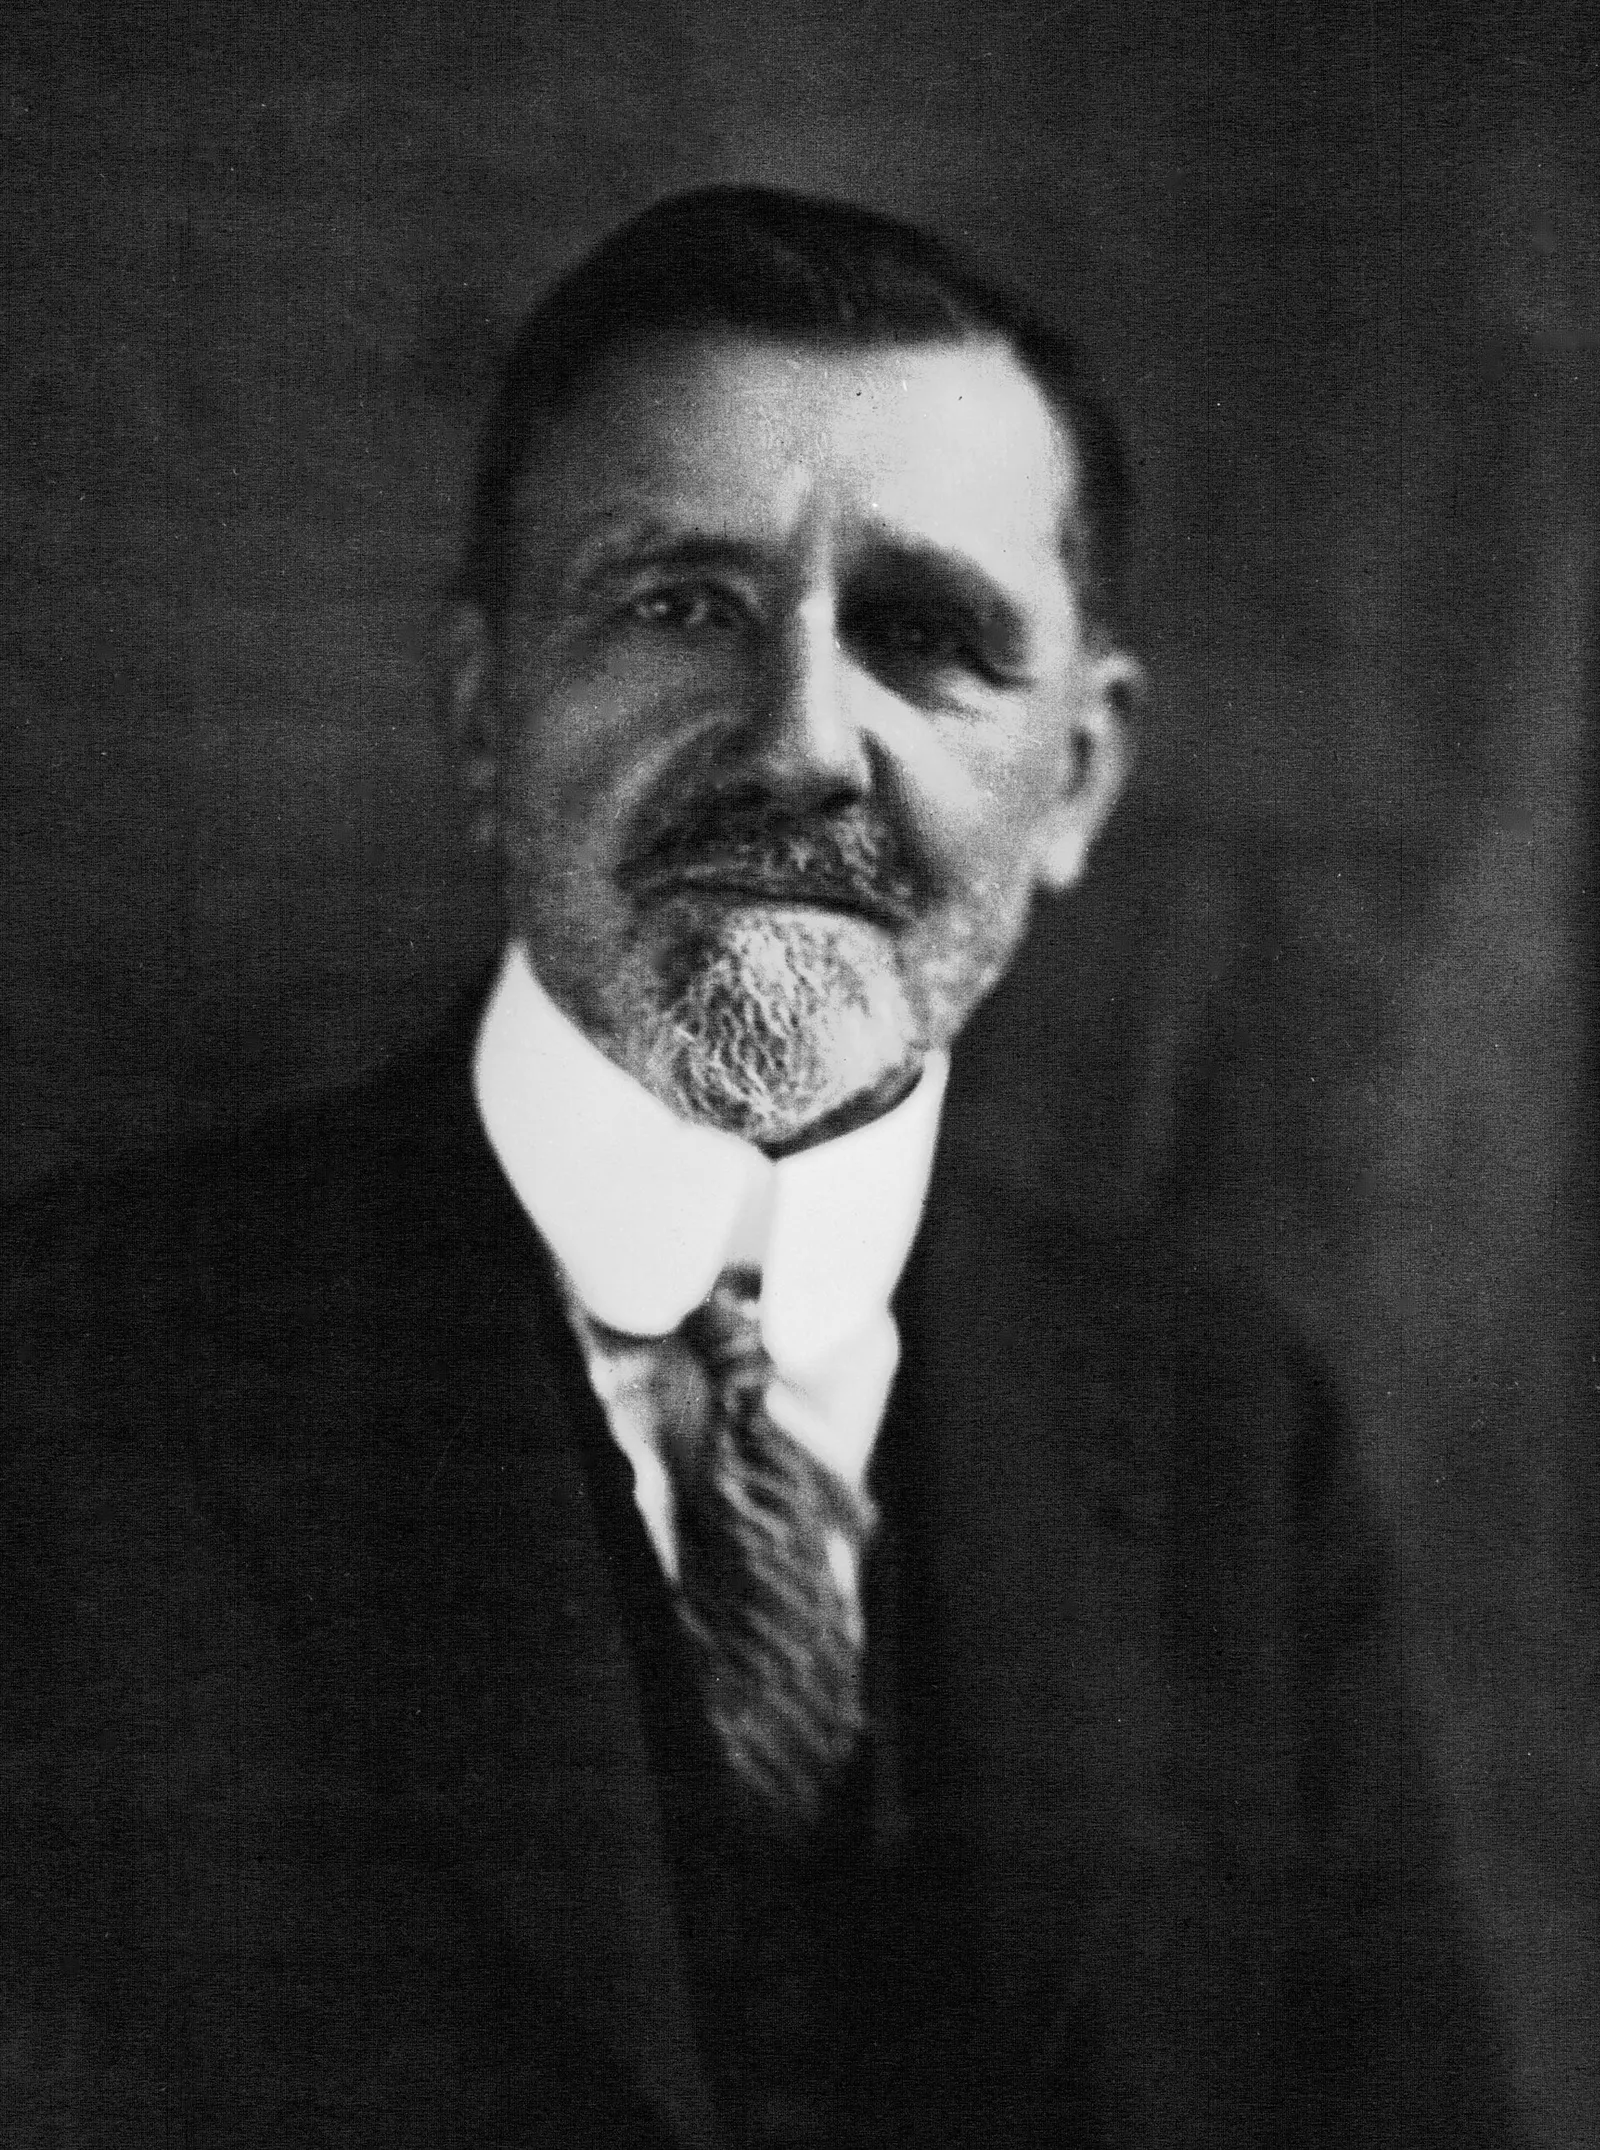
O macaco da máquina de escrever é quase um século mais velho que Pelevin. O matemático francês Émile Borel o inventou em 1913, ao explicar o que significa “praticamente impossível”: um evento pode ser permitido pelas leis da probabilidade e mesmo assim não acontecer nem uma única vez em toda a existência do universo. A conta é fácil, e vale a pena fazê-la pelo menos uma vez para sentir a escala. Se o teclado tem noventa caracteres, existem noventa elevado a cem linhas possíveis de cem caracteres, ou seja, mais ou menos um seguido de cento e noventa e cinco zeros. No universo observável há, pelas estimativas atuais, cerca de um seguido de oitenta zeros átomos. Mesmo que se transformasse cada átomo num macaco, se o sentasse diante de uma máquina de escrever e se o obrigasse a datilografar um bilhão de linhas por segundo desde o Big Bang, esse exército não chegaria a uma única linha correta de código, e um programa que faça qualquer coisa consiste em milhares de linhas assim.
Os engenheiros, aliás, tentaram o macaco, só que numa versão refinada. Em 1992 o cientista americano John Koza publicou o livro Programação Genética, em que propunha cultivar programas como a natureza cultiva espécies: pega-se uma população de programas aleatórios, verifica-se quais resolvem o problema pelo menos um pouco melhor que os vizinhos, cruzam-se os bem-sucedidos, acrescentam-se mutações aleatórias e repete-se até sair algo aproveitável. O método funcionava, em alguns casos muito bem, mas só em problemas pequenos, em que o programa cabia em algumas dezenas de operações. Num problema do tamanho de um aplicativo bancário, a evolução precisaria de um tempo comparável ao que a evolução de verdade levou para ir dos organismos unicelulares aos contadores, e o cliente costuma querer o resultado até o fim do trimestre.
O ponto fraco dos dois esquemas, o de Borel e o de Koza, era a própria aleatoriedade. O macaco aperta todas as teclas com a mesma probabilidade, e a mutação muda qualquer símbolo do programa com a mesma facilidade, então quase todas as variantes acabam sendo lixo, e nenhuma seleção dá conta de uma montanha de lixo desse tamanho. Se o macaco soubesse pelo menos um pouco quais letras costumam vir depois de quais, a coisa andaria de outro jeito. Se ele tivesse lido tudo o que a humanidade datilografou antes dele, andaria de um jeito completamente diferente.
Em maio de 2020 os engenheiros da OpenAI reuniram no GitHub, o maior repositório compartilhado de código do mundo, cinquenta e quatro milhões de projetos abertos e separaram tudo o que estava escrito na linguagem Python. Depois da limpeza sobraram cento e cinquenta e nove gigabytes de texto, ou seja, grosso modo, alguns bilhões de linhas que as pessoas escreveram, corrigiram, comentaram e xingaram ao longo de décadas. Com essas linhas treinou-se um modelo chamado Codex, e em julho de 2021 saiu o artigo com os seus resultados.
O que um modelo assim sabe fazer é mais fácil de explicar sem as palavras “rede neural” e “inteligência artificial”. O modelo vê o começo de um texto e prevê o que mais provavelmente vem a seguir, depois escreve essa continuação, olha de novo para o texto resultante, prevê de novo, e assim símbolo por símbolo. Quando foi treinado com código, viu milhões de vezes como costuma terminar uma linha começada de determinado jeito, como costuma ser montada uma função que ordena uma lista e quais erros as pessoas mais corrigiam na versão seguinte. A rigor, o modelo continua escolhendo o próximo símbolo ao acaso, mas as probabilidades dele não são iguais: ele joga dados viciados com todo o código que as pessoas escreveram antes dele. É o mesmo macaco de Borel, só que tendo lido o GitHub inteiro.
Os autores do artigo sobre o Codex criaram cento e sessenta e quatro problemas, cada um com um conjunto de verificações automáticas que mostram se a solução funciona ou não. Na primeira tentativa o modelo resolvia 28,8 por cento dos problemas, o que para uma máquina de 2021 era razoável e para um programador, medíocre. Depois os pesquisadores fizeram uma coisa muito pelevinesca: pediram ao modelo que escrevesse cem soluções candidatas para cada problema e olharam se entre essas cem haveria pelo menos uma que passasse nas verificações. Isso aconteceu em 70,2 por cento dos problemas. O próprio artigo chama modestamente esse truque de estratégia surpreendentemente eficaz, embora se trate do método de Reznik em estado puro: gerar muito código e ficar com o que passou no teste.
Meio ano depois o laboratório de pesquisa DeepMind levou a mesma ideia a escala industrial. O seu sistema AlphaCode participou de competições de programação, em que pessoas resolvem contra o relógio problemas pensados para ser difíceis. Para cada problema o AlphaCode gerava uma quantidade enorme de programas, em alguns problemas na casa dos milhões, e depois descartava todos os que não davam conta dos exemplos do enunciado. A seleção destruía cerca de noventa e nove por cento do que tinha sido escrito. O sistema agrupava os milhares de variantes restantes por semelhança de comportamento e mandava ao júri no máximo dez. No conjunto de várias competições na plataforma Codeforces, ficou mais ou menos no meio da tabela, acima de 46 por cento dos participantes humanos, entre os quais havia muitos programadores fortíssimos que passaram anos treinando.
Ou seja, Pelevin adivinhou o esquema quase por inteiro: geração, teste exaustivo, seleção dos sobreviventes. Errou só ao imaginar a geração como cega, quando as máquinas dos anos 2020 geram com uma mira acumulada no código de toda a humanidade. Essa única correção tirou o macaco da categoria dos experimentos mentais e o pôs na categoria das ferramentas de trabalho.
 ilustração
No dia dois de fevereiro de 2025 Andrej Karpathy, um dos pesquisadores mais conhecidos da área, escreveu numa rede social um post curto que ele mesmo depois chamou de ideia que lhe veio no chuveiro. Descreveu uma nova maneira de programar em que você se entrega totalmente à sensação, abraça o crescimento exponencial e esquece que o código sequer existe: diz à máquina o que quer, olha o resultado e, se algo quebrou, copia a mensagem de erro de volta e pede para consertar. Chamou isso de vibe coding, programação na base da sensação. Nove meses depois o dicionário Collins declarou vibe coding a palavra do ano de 2025.
Se você comparar o post de Karpathy com o esquema de Reznik, a semelhança chega a assustar. A geração fica a cargo do modelo, aquele macaco que leu o GitHub. Seleção também existe, só que o teste exaustivo do romance foi substituído por uma pessoa que olha para a tela e decide se o que ela vê se parece com o que ela queria. Se o botão pode ser clicado, funciona; se a página abriu, está pronto; se saltou um erro, ele é mandado ao modelo e gera-se a próxima variante.
O vibe coding parece uma revolução súbita de fevereiro de 2025 só para quem não leu nem Pelevin, nem o artigo sobre o Codex. Pela estrutura, é o Random Code Programming com uma enorme vantagem inicial na forma de todo o código público da humanidade, e com o papel de comissão julgadora entregue a uma única pessoa cansada diante da tela.
Eu mesmo cheguei a essa comparação pouco mais de quatro meses depois de Karpathy, em circunstâncias que Pelevin provavelmente teria apreciado. No verão de 2025 eu já montava programas como o post descreve: explicava ao modelo o que queria, rodava o que ele produzia, via onde aquilo desabava e devolvia o erro, até que depois de algumas voltas algo funcional se formasse a partir de pedaços plausíveis. No dia vinte e um de junho, numa conversa com um desses modelos, eu me lembrei de Reznik e escrevi uma frase que cito literalmente, porque não há como dizê-la de forma mais curta: “o random code programming do Pelevin é basicamente vibe coding”. O modelo objetou educadamente que em Pelevin aquilo é mais uma imagem satírica e sugeriu discutir do que exatamente o escritor estava zombando. Tive de pedir que ele parasse de fantasiar e encontrasse no romance o próprio princípio, de modo que, vista de fora, a cena era bastante pelevinesca: eu explicava ao macaco que ele era um macaco, e o macaco me oferecia em troca uma análise literária.
Dois meses depois, no dia vinte e cinco de agosto, a ideia ficou mais desagradável. Escrevi de novo que RCP é random code programming, leia-se vibe coding, e dessa vez acrescentei que, do ponto de vista da própria rede neural, não há diferença nenhuma entre os dois. Para o modelo tanto faz se o seu trabalho se chama programação, bordado ou geração de variantes: em todos os casos ele continua o texto da maneira mais provável, e a diferença entre “escreveu um programa” e “produziu uma sequência plausível de símbolos” só surge do lado de fora, no momento em que alguém roda essa sequência e vê o que acontece. Naquele mesmo verão me escapou também uma frase mais ampla, sobre o universo inteiro, visto objetivamente, funcionar por RCP, mas a ela chegaremos só no fim do livro. E em maio de 2026, contando como eu mesmo desenvolvo programas hoje, eu já falava do método de Pelevin sem aspas nenhumas: é o que eu uso.
Se um programa que funciona pode mesmo surgir da geração de variantes, da seleção e do acúmulo de estados bem-sucedidos, surge uma pergunta incômoda: o que exatamente chamamos de programação durante sessenta anos? É fácil deixar a resposta passar, porque o gerador rouba toda a atenção. Os modelos escrevem código mais rápido que as pessoas, os modelos escrevem código mais barato que as pessoas, a cada seis meses sai um novo modelo que escreve mais rápido e mais barato ainda, e todas as conversas giram em torno de qual modelo é mais forte. No entanto, tanto no romance de Pelevin quanto no artigo sobre o Codex e no sistema AlphaCode, toda a inteligência da construção está na seleção. Um gerador aleatório, mesmo muito bem treinado, produz variantes, mas quem decide qual delas merece viver é a verificação, e da qualidade dela depende o que acaba sobrevivendo. Cem variantes do Codex sem testes automáticos seriam apenas cem textos de aparência plausível, entre os quais não há como distinguir o que funciona do que não funciona. Um milhão de programas do AlphaCode sem os exemplos do enunciado seriam um milhão de programas e mais nada.
O Random Code Programming funciona pela simples razão de que a seleção se revelou mais importante que a origem da variante. Para a verificação tanto faz se a solução foi inventada por um engenheiro genial depois de uma noite em claro, montada pela evolução ao longo de um milhão de gerações ou produzida por um modelo na quadragésima sétima tentativa: o código ou passa na verificação, ou vai para o lixo, e se a verificação é boa, sobrevive o que é bom. Essa observação, levada até o fim, explica quase tudo de que o livro vai tratar daqui para a frente, dos testes e fiscais automáticos à memória das máquinas e aos lugares em que as pessoas vão se mostrar insubstituíveis.
É curioso que Pelevin tenha entendido isso melhor que muitos engenheiros. No esquema de Reznik, as sequências bem-sucedidas ganham vida porque nelas, nas palavras do herói, entra por dentro algo chamado Mente do Mundo. Os desenvolvedores de hoje costumam procurar a mente do mundo no próprio modelo e discutem se ele entende o que escreve. Acho que ela deve ser procurada em outro lugar, ali onde se decide qual das variantes escritas fica e qual vai para o lixo.
No vibe coding esse trabalho cabe à pessoa que olha para a tela, e ela dá conta dele enquanto o programa é pequeno e as consequências de um erro se resumem a um botão da cor errada. Depois o programa cresce, por trás dele passam a estar o dinheiro e os dados de outras pessoas, enquanto quem verifica continua olhando só se a página abriu, e o macaco que leu o GitHub inteiro se vê diante de uma comissão que julga Guerra e Paz pela capa.